Waarom beginnen de grote spelers in de kunstmatige intelligentie onzichtbare watermerken in hun inhoud te verwerken? Het eerste antwoord lijkt voor de hand te liggen: om aan de AI Act te voldoen. Dat klopt, maar het is niet volledig.
Het antwoord dat voor de hand ligt: artikel 50 van de AI Act
Artikel 50 van de Europese verordening vraagt aanbieders van systemen die tekst, beeld, geluid of video voortbrengen om hun voortbrengselen herkenbaar en gemerkt te maken, in een vorm die een machine kan lezen. De verplichting gaat niet over een zichtbare vermelding op het scherm; ze gaat over een signaal dat verderop in de keten door om het even welke partij automatisch bruikbaar is.
De initiatieven van de grote aanbieders passen duidelijk in die lijn. Anthropic verwerkt nu een statistisch signaal in bepaalde teksten die Claude voortbrengt. OpenAI gebruikt onder meer C2PA-metagegevens en SynthID-watermerken voor bepaalde beeld- en geluidsinhoud, met de bedoeling die herkomstsignalen naar andere vormen uit te breiden.
Het web is tegelijk de bron en de afvoer geworden
Het watermerk terugbrengen tot een wettelijke formaliteit zou misschien betekenen dat men een dieper vraagstuk mist.
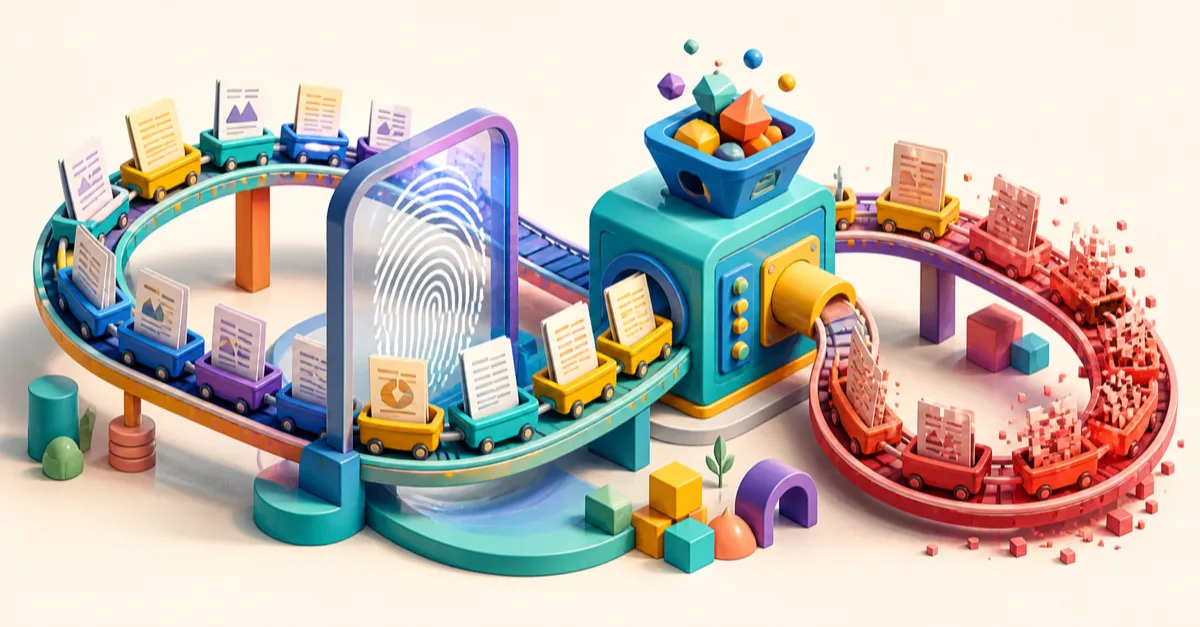
Het web wordt tegelijk de bibliotheek waarin de AI's leren en de ruimte waarin ze hun eigen voortbrengselen storten. Worden de volgende generaties modellen zonder onderscheid getraind op groeiende hoeveelheden synthetische inhoud, dan dreigen ze hun eigen benaderingen te herhalen, bepaalde fouten te versterken en gaandeweg de verscheidenheid te verliezen die in menselijke gegevens zit.
Dat verschijnsel heet instorting van modellen, of model collapse. Het werk dat in Nature is verschenen over recursief trainen laat zien dat de aftakeling zich niet eerst in spectaculaire fouten toont, maar in het stille verdwijnen van de zeldzame gevallen: de verdeling trekt zich samen rond haar eigen gemiddelde.
Het watermerk als werktuig voor gegevensbestuur
In dat licht verandert het watermerk van aard. Het zou platformen, zoekmachines en bouwers van gegevensverzamelingen in theorie in staat stellen menselijke inhoud van synthetische inhoud te onderscheiden, en die vervolgens te signaleren, te filteren of anders te wegen.
Met andere woorden: een merkteken dat vandaag wordt uitgerold om een toezichthouder tevreden te stellen, zou morgen kunnen dienen om de grondstof te beschermen waarvan de hele bedrijfstak afhangt, namelijk trainingsgegevens waarvan de herkomst nog te bepalen valt.
Wat het watermerk niet bewijst
Dat voordeel blijft evenwel onrechtstreeks, en de grenzen verdienen het zonder omhaal te worden benoemd.
- Geen enkel watermerk waarborgt dat inhoud waar is; een gemerkte tekst kan onjuist zijn, een ongemerkte tekst kan kloppen.
- Geen enkel watermerk waarborgt dat de inhoud na het voortbrengen niet is gewijzigd.
- De techniek blijft bijzonder broos voor tekst: een herformulering of een parafrase kan volstaan om een statistisch signaal te verstoren.
- Metagegevens kunnen verdwijnen bij een omzetting, een compressie of een deling op een platform dat bestanden hercodeert.
Rechtstreeks gevolg: het ontbreken van een merkteken bewijst geen menselijke herkomst. Een rangschikkingssysteem dat het watermerk als bewijs behandelt, en niet als aanwijzing, zou zich in beide richtingen vergissen.
Drie niveaus van dezelfde vraag
Het antwoord op de beginvraag luidt waarschijnlijk zo. Watermerken worden eerst uitgerold om aan de doorzichtigheidsplichten van de AI Act te voldoen. Ze kunnen vervolgens zoekmachines helpen de herkomst van inhoud beter te bepalen. En op langere termijn zouden ze kunnen bijdragen aan de bescherming van toekomstige modellen tegen een ongecontroleerde voeding met synthetische gegevens.
Het is dus misschien geen keuze tussen regelgeving, kwaliteit van het web en voortbestaan van de modellen. Het is dezelfde vraag, bekeken op drie verschillende niveaus: juridisch, informationeel en technologisch.
Wat dit voor een onderneming betekent
Voor een organisatie die inhoud voortbrengt of gebruikt, worden vanaf nu drie gewoonten nuttig.
- De herkomst van de eigen corpora vastleggen. Weten wat in een documentenbestand door een mens is geschreven, door een mens is nagelezen of door een model is voortgebracht, is bestuursinformatie, geen redactioneel detail.
- Merken niet verwarren met valideren. Herkomst wordt gevolgd, waarheid wordt geverifieerd. Dat zijn twee verschillende inrichtingen, met twee verschillende verantwoordelijken.
- De menselijke gegevens bewaren. De archieven van vóór de generatieve golf, de interne verslagen, de vakinhoudelijke gesprekken vormen een bezit waarvan de betrekkelijke waarde stijgt naarmate het openbare web synthetischer wordt.
Dat is precies de lijn die wij in BrainDup volgen: elk antwoord steunt op aangewezen bronnen, en de herkomst van de ingenomen documenten blijft van begin tot eind gevolgd. Om erover te praten, maak een afspraak of schrijf ons.
De vraag die openblijft
Eén wezenlijke vraag blijft staan: moeten wij het watermerk zien als een eenvoudige aanwijzing van herkomst, of moet het ook een maatstaf worden voor rangschikking, selectie en training?
Het antwoord is niet alleen technisch. Het zal bepalen wat morgen het recht heeft waarvan te leren.
Bronnen en verdere lectuur
- Europese verordening over kunstmatige intelligentie: officiële tekst, in het bijzonder artikel 50
- Overzicht en thematische toegang tot de AI Act, in het Engels
- Anthropic: Claude text watermark, in het Engels
- Liora: beginselen en toepassingen van AI watermarking, in het Frans
- Sean Goedecke: grenzen en broosheid van watermerken op tekst, in het Engels
- OpenAI: Content Credentials, C2PA en SynthID, in het Engels
- Wikipedia: modelinstorting bij kunstmatige intelligentie
- Nature: gevolgen van recursief trainen op door AI voortgebrachte gegevens, in het Engels
- AS3P (11 augustus 2026): « AI Act: hoe BrainDup antwoordt, artikel per artikel »